spark算子---mapPartitions
spark算子—mapPartitions
2018-05-11 12:28:19 更多
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/wuxintdrh/article/details/80278479
1. mapPartitions算子
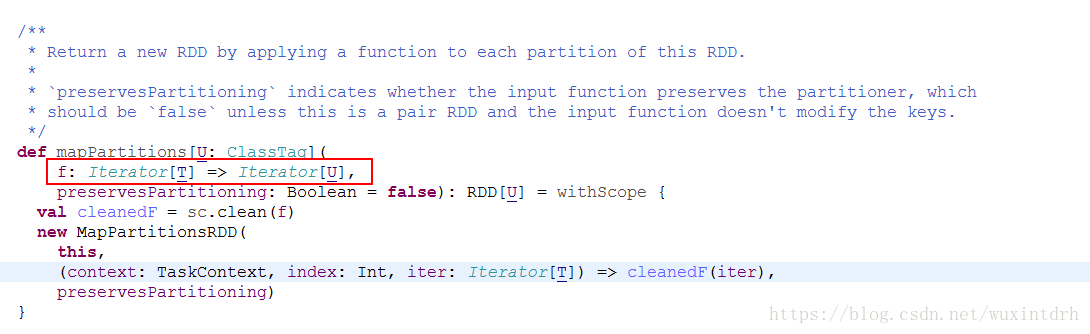
1、首先看下f: Iterator[T] => Iterator[U],
Scala的解释器在**解析函数参数(function arguments)**时有两种方式:
- 传值调用(call-by-value):先计算参数表达式的值,再应用到函数内部;
- 传名调用(call-by-name):将未计算的参数表达式直接应用到函数内部
在进入函数内部前,传值调用方式就已经将参数表达式的值计算完毕,而传名调用是在函数内部进行参数表达式的值计算的。
这就造成了一种现象,每次使用传名调用时,解释器都会计算一次表达式的值。
1 | object Test { |
以上实例中我们声明了 delayed 方法, 该方法在变量名和变量类型使用 => 符号来设置传名调用。执行以上代码,输出结果如下:
1 | $ scalac Test.scala |
实例中 delay 方法打印了一条信息表示进入了该方法,接着 delay 方法打印接收到的值,最后再返回 t。
2. 高阶函数
1 | //===============高阶函数start==================== |
2. 再来看mapPartitions算子
调用
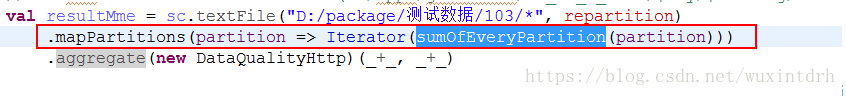
传入的又是一个匿名函数
3. map与mapPartitions的区别
- map: 比如一个partition中有1万条数据;那么你的function要执行和计算1万次。
- MapPartitions:一个task仅仅会执行一次function,function一次接收所有的partition数据。只要执行一次就可以了,性能比较高。
如果在map过程中需要频繁创建额外的对象(例如将rdd中的数据通过jdbc写入数据库,map需要为每个元素创建一个链接而mapPartition为每个partition创建一个链接),则mapPartitions效率比map高的多。
SparkSql或DataFrame默认会对程序进行mapPartition的优化。
4. MapPartitions的缺点:一定是有的。
如果是普通的map操作,一次function的执行就处理一条数据;那么如果内存不够用的情况下,比如处理了1千条数据了,那么这个时候内存不够了,那么就可以将已经处理完的1千条数据从内存里面垃圾回收掉,或者用其他方法,腾出空间来吧。
所以说普通的map操作通常不会导致内存的OOM异常。
但是MapPartitions操作,对于大量数据来说,比如甚至一个partition,100万数据,一次传入一个function以后,那么可能一下子内存不够,但是又没有办法去腾出内存空间来,可能就OOM,内存溢出。
spark中map与mapPartitions区别
在spark中,map与mapPartitions两个函数都是比较常用,这里使用代码来解释一下两者区别
1 | import org.apache.spark.{SparkConf, SparkContext} |
两个函数最终处理得到的结果是一样的
mapPartitions比较适合需要分批处理数据的情况,比如将数据插入某个表,每批数据只需要开启一次数据库连接,大大减少了连接开支,伪代码如下:
1 | arrayRDD.mapPartitions(datas=>{ |